Toda aplicação da plataforma Embrapa I/O já sabe fazer o próprio backup. Mas o arquivo nasce no mesmo servidor em que a build roda, e um incidente nesse servidor, como uma falha de disco, um ransomware ou a exclusão acidental da VM, leva a aplicação e o backup juntos. A boa prática é a regra 3-2-1: três cópias, em dois tipos de mídia, uma delas fora do local.
A partir de agora, isso é feito pela própria plataforma. O Backup S3 copia, todos os dias, os backups das builds dos clusters compartilhados para um bucket S3 e permite restaurá-los na build quando for preciso. Veja como funciona, da configuração ao restore, na vídeo-aula:
Configuração em dois passos
Um Architect (arquiteto da solução) do projeto configura o Backup S3 no Dashboard, no item Backup S3 da seção Avançado do menu do card do projeto:
-
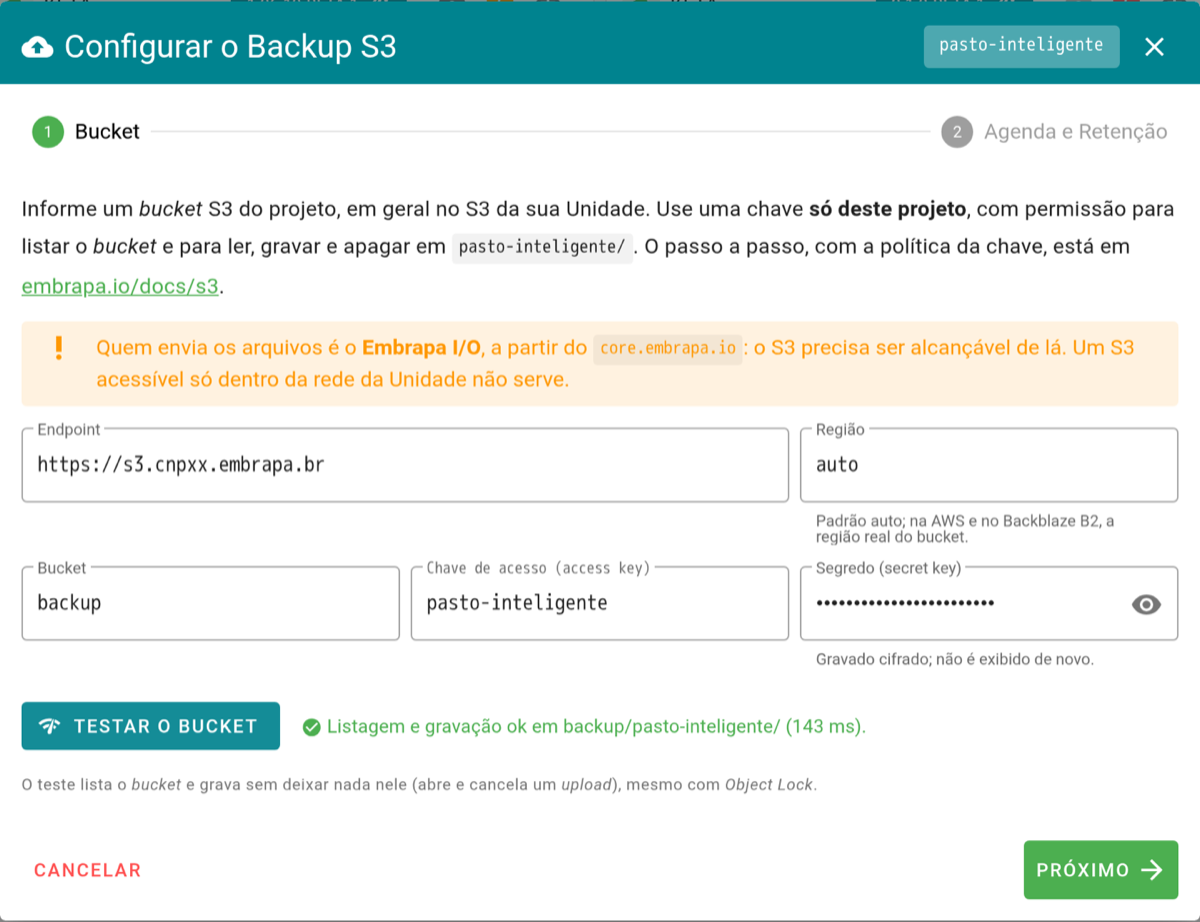
Bucket: o endereço do S3, o bucket, a região e a chave do projeto. O botão Testar o Bucket confere se a chave consegue listar e gravar, sem deixar nenhum arquivo para trás, e a configuração só é salva se o teste passar. O segredo é guardado cifrado.
-
Agenda e Retenção: os estágios incluídos, a hora da rodada diária e a retenção, no mesmo formato do Releaser (padrão
7/4/3/1: sete backups diários, quatro semanais, três mensais e um anual).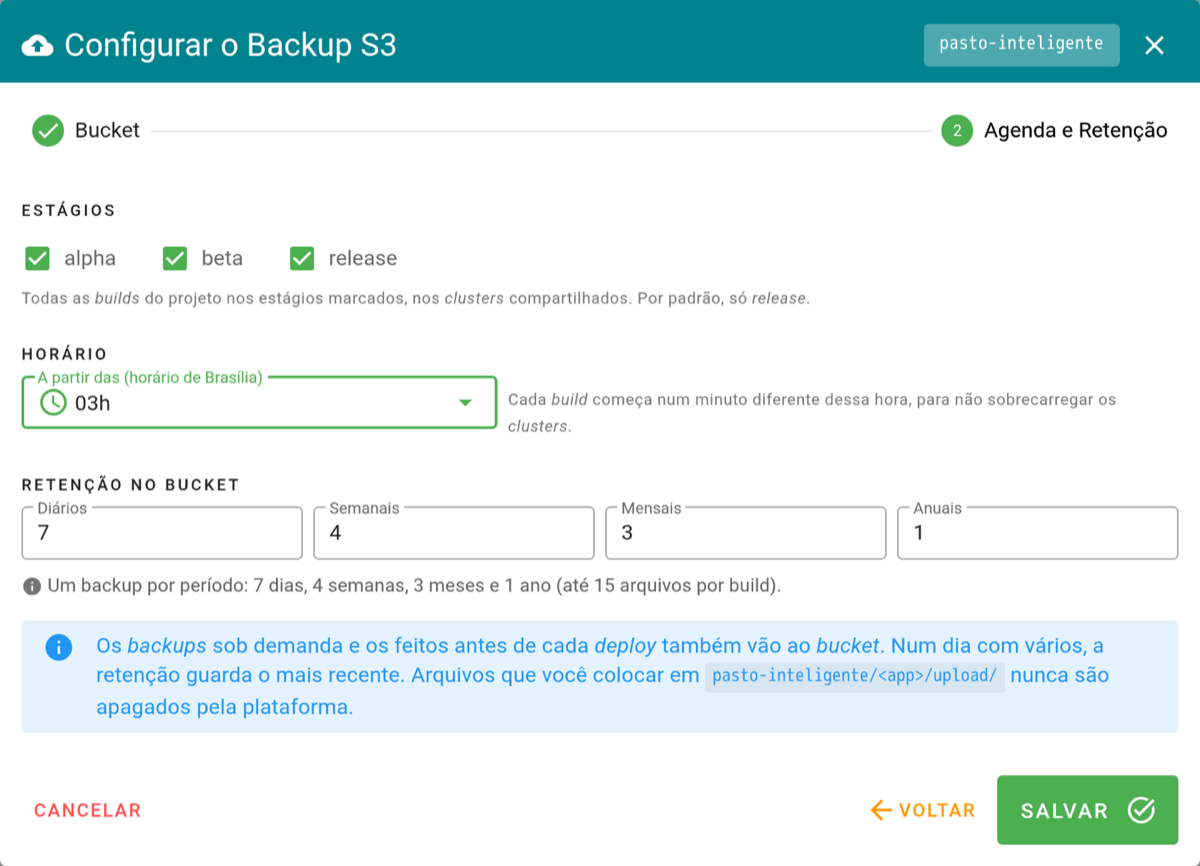
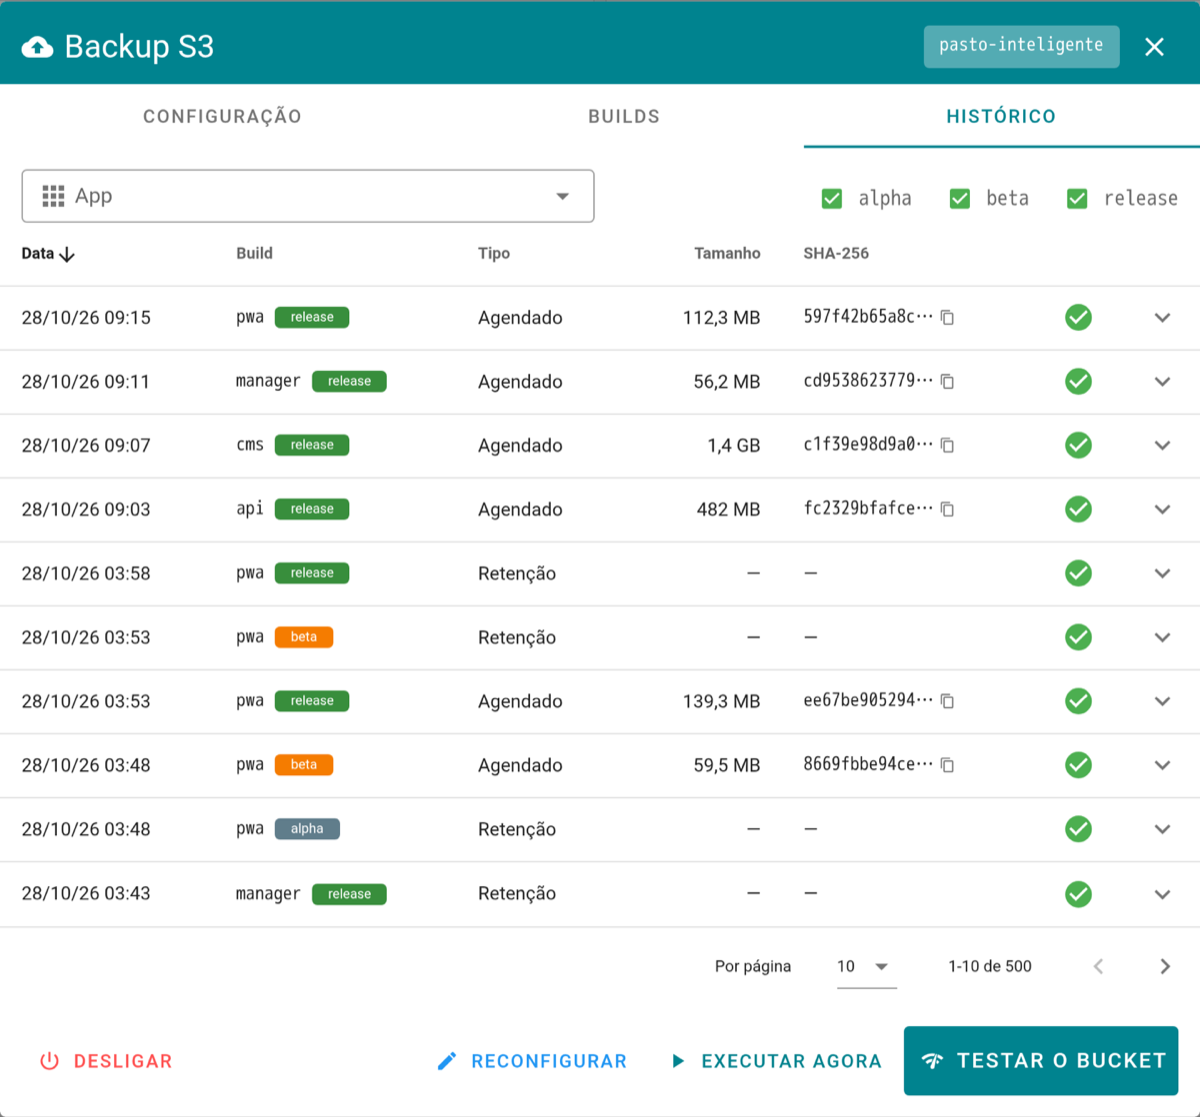
Na hora marcada, para cada build incluída, a plataforma roda o serviço backup da app, envia o arquivo ao bucket, confere o tamanho, apaga a cópia do storage do cluster e aplica a retenção. Os backups feitos fora da rodada, pelo botão Backup do Health Check ou antes de cada deploy, também sobem, a cada 15 minutos. Falhas chegam por e-mail aos Architects do projeto. Na aba Histórico, fica cada envio, com a origem, o tamanho e o SHA-256 do arquivo:
Use sempre uma chave própria do projeto, nunca a de administração do S3. O destino pode ser um serviço comercial, mas o recomendado é o S3 da sua Unidade: os dados ficam dentro da Embrapa e não há custo por gigabyte. A documentação mostra como montar um com os boilerplates silo e caddy, do mesmo jeito que foi montado o S3 do Embrapa I/O.
Restore pelo Health Check
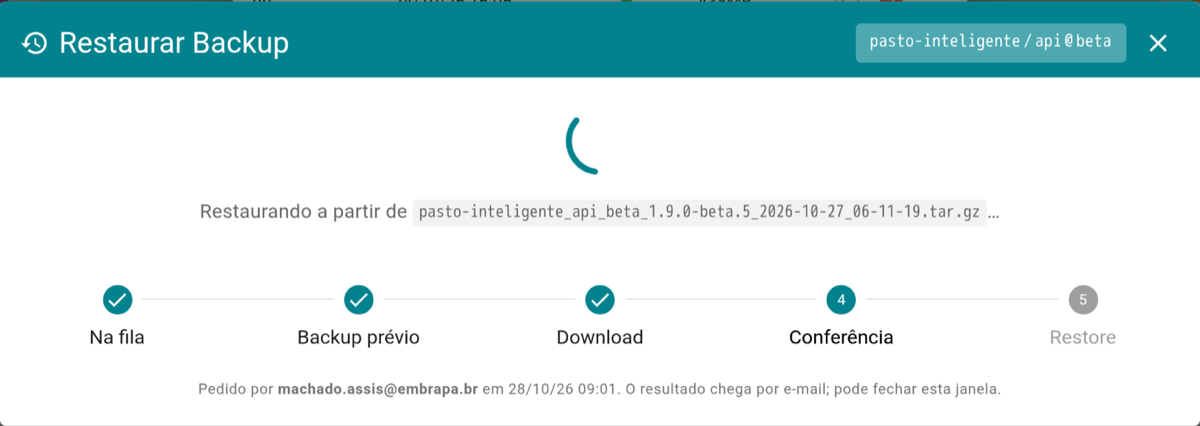
No Health Check da build, o item Restaurar Backup do menu lista os arquivos do bucket da app, dos três estágios. O restore é exclusivo dos Architects do projeto: escolhido o arquivo, quem pediu recebe um PIN por e-mail e, confirmado o PIN, o pedido entra na fila.
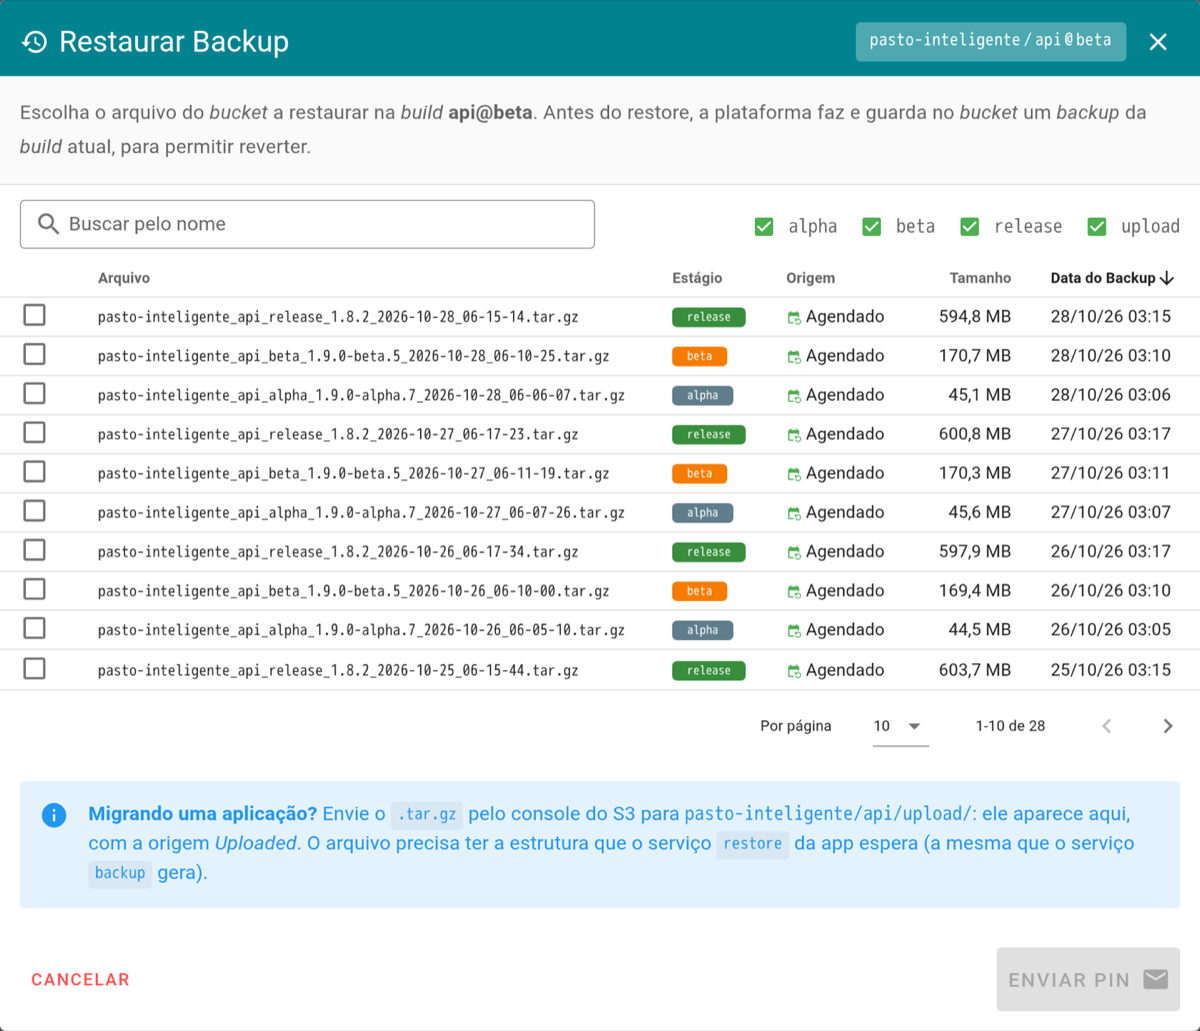
O restore passa por quatro etapas:
- um backup do estado atual, guardado por 30 dias, para você poder desfazer;
- o download do arquivo para o cluster;
- a conferência do SHA-256 e da integridade do arquivo;
- o restore pelo serviço
restoreda própria app.
O andamento aparece na tela e o resultado chega por e-mail.
Migração de dados de outros sistemas
O mesmo caminho serve para trazer dados de fora da plataforma, como de um servidor antigo. Envie o arquivo para a pasta upload/ da app no bucket, com qualquer cliente S3 (o console do Silo, o mc, o rclone), e ele aparece na lista do Restaurar Backup, com a origem Uploaded. O arquivo precisa ter a mesma estrutura do backup que a app gera: o jeito mais seguro é fazer um backup da build, ver como ele é montado e preparar o seu arquivo igual.
E nos servidores com Releaser?
Nas builds implantadas pelo Releaser, a cópia em nuvem é feita no próprio servidor, pelo comando io cloud e pelo atributo auto.cloud do arquivo da build, disponíveis a partir da versão 1.26.10-12. E, desde a 1.26.10-16, o comando io restore restaura na build um arquivo do volume de backup ou do bucket (inclusive os da pasta upload/), com as mesmas etapas do restore dos clusters. O mesmo bucket da Unidade serve aos dois caminhos.
Todos os detalhes, inclusive como montar o S3 da Unidade, estão no capítulo Backup S3 da documentação.