Uma dúvida recorrente das equipes e dos Núcleos de Tecnologia da Informação (NTIs) das Unidades é onde cada versão de uma aplicação deve rodar e por qual mecanismo ela deve ser publicada. A resposta depende de duas variáveis: o estágio de maturidade da build e o Tier da infraestrutura disponível.
Chamamos de Tier (do inglês, patamar ou camada) o nível de robustez e de suporte de uma infraestrutura, numerado de 0 a 4: do computador do desenvolvedor, sem qualquer salvaguarda, até a nuvem contratada com suporte 24x7. É uma classificação da infraestrutura, inspirada nos tiers de data center usados pelo mercado, e não um acordo de nível de serviço (SLA) com métricas e penalidades contratuais. Os cinco Tiers estão definidos adiante.
Em uma frase: use o catálogo de clusters compartilhados da plataforma para os estágios de menor maturidade e o utilitário Releaser, em máquina dedicada, para produção. As seções a seguir explicam o porquê, listam os critérios que podem alterar essa regra e detalham as responsabilidades de cada caminho.
Contexto
A plataforma Embrapa I/O atende a dois universos distintos de software. De um lado estão os sistemas gerenciais: sistemas de informação, utilitários e ferramentas de apoio institucional e de automação de processos da Sede e das Unidades, como o Ideare, o Integro, o ERP/SAP, o SEI, o SIExp, o Redape, o Alelo e o GeoInfo. De outro estão os ativos digitais agropecuários: aplicativos móveis, aplicações web, software embarcado, ferramentas de desktop, APIs e modelos de linguagem voltados à agricultura, à pecuária, às florestas, à aquicultura e à indústria de processamento, organizados em produtos e plataformas institucionais e em ecossistemas temáticos digitais.
Os dois universos compartilham os mesmos desenvolvedores e a mesma plataforma, e é por isso que a orientação sobre publicação vale para ambos. O que muda é o destino final da instância de produção: sistemas gerenciais de uso global tendem para o data center da Sede, e ativos digitais agropecuários para o ambiente AgroDigital, na Embrapa Agricultura Digital, ou para a infraestrutura da própria Unidade.
Estágios, builds e o que é instanciado
O processo de desenvolvimento da plataforma possui quatro estágios: development (desenvolvimento, no computador do desenvolvedor), alpha (testes internos, em ambientes de baixa robustez), beta (testes externos ou homologação, em ambientes de pelo menos média robustez) e release (produção, em ambientes de alta robustez, com resiliência, monitoramento e salvaguardas).
A unidade de publicação é a build, a combinação de uma aplicação com um estágio (siexp/coletor@alpha, siexp/coletor@beta, siexp/coletor@release), que recebe versões sucessivas. Cada build é uma instância totalmente independente das demais, com seus próprios dados, instanciada como uma pilha (stack) de containers com volumes e rede isolados, em um servidor ou VM que pode ser diferente para cada estágio. É esse isolamento que permite escolher o destino de cada build separadamente: a alpha pode viver em um cluster compartilhado enquanto a release roda em uma máquina dedicada.
Métodos de deploy
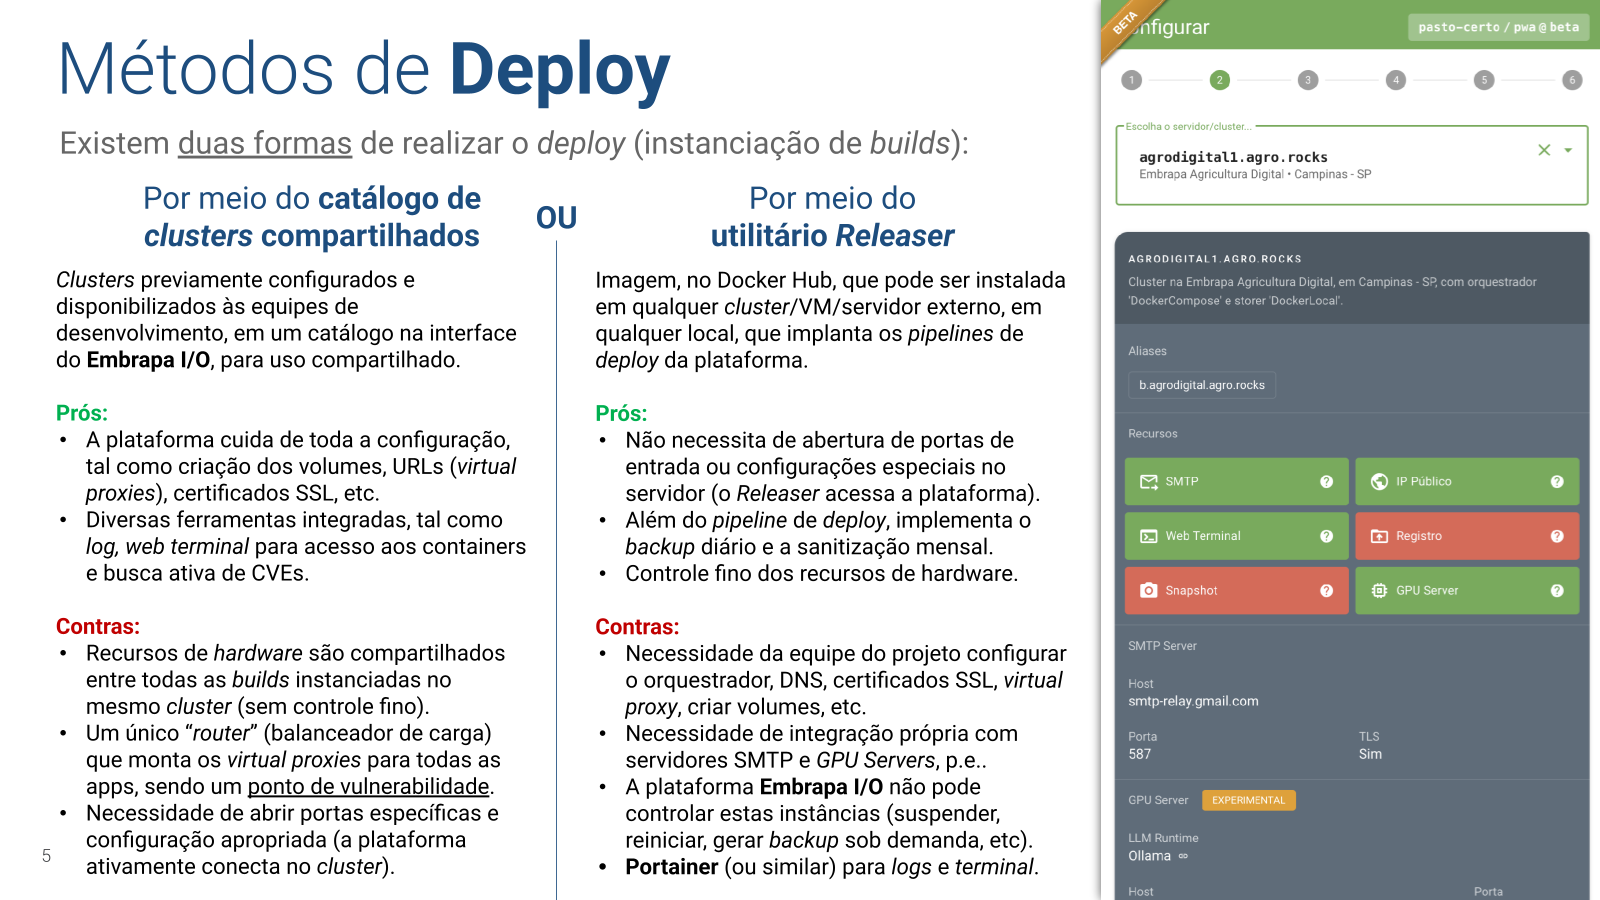
Existem duas formas de realizar o deploy (a instanciação de uma build):
Pelo catálogo de clusters compartilhados
São clusters previamente configurados e disponibilizados às equipes de desenvolvimento em um catálogo na interface da plataforma, para uso compartilhado. A equipe escolhe o cluster ao configurar a build e o deploy acontece ao criar uma tag no repositório.
Prós:
- A plataforma cuida de toda a configuração: criação dos volumes, URLs (virtual proxies), certificados SSL, variáveis de ambiente, integração com SMTP e GPU Servers.
- Diversas ferramentas vêm integradas: log centralizado, web terminal para acesso aos containers e monitoramento pela dashboard.
- Busca ativa de vulnerabilidades (CVEs) nas imagens construídas para a build. Essa varredura só é possível aqui, porque é no deploy pelo cluster que a plataforma constrói as imagens e passa a conhecer todas as dependências da aplicação.
Contras:
- Os recursos de hardware (disco, memória, processamento) são compartilhados entre todas as builds instanciadas no mesmo cluster, sem controle fino por aplicação.
- Um único router (balanceador de carga) monta os virtual proxies de todas as aplicações do cluster, o que o torna um ponto de vulnerabilidade e de falha.
- É necessário abrir portas específicas e fazer uma configuração apropriada no servidor, porque a plataforma conecta ativamente no cluster para operá-lo.
Pelo utilitário Releaser
O Releaser é uma imagem pública no Docker Hub que pode ser instalada em qualquer cluster, VM ou servidor externo, em qualquer local, e que implanta os pipelines de deploy da plataforma nesse servidor. Roda como um container com acesso ao socket do Docker, expõe o comando io com as operações de validate, deploy, stop, restart, rollback, backup, sanitize e info, e opera como serviço em segundo plano mantendo as builds na versão mais recente.
Prós:
- Não exige abertura de portas de entrada nem configurações especiais no servidor: é o Releaser que acessa a plataforma, e não o contrário.
- Além do pipeline de deploy, implementa o backup diário e a sanitização mensal das builds.
- Permite controle fino dos recursos de hardware, já que a máquina é da equipe.
- As integrações configuradas por build (Sentry, Matomo, SonarQube) continuam funcionando exatamente como nos clusters do catálogo.
Contras:
- A equipe do projeto (ou o NTI da Unidade) precisa configurar o orquestrador, o DNS, os certificados SSL, o virtual proxy e os volumes.
- Integrações com servidores SMTP e GPU Servers, por exemplo, precisam ser providenciadas pela própria equipe.
- A plataforma não controla essas instâncias: não consegue suspender, reiniciar ou gerar backup sob demanda pela dashboard.
- Ainda não há busca ativa de CVEs nas imagens. Hoje o Releaser puxa imagens prontas e não participa da construção, então não inventaria as dependências. Há plano de levar a varredura (Trivy) ao Releaser; até lá, a proteção é manter as imagens atualizadas.
- Não há web terminal nem logs na dashboard: para isso, recomenda-se instalar o Portainer ou ferramenta similar e, para centralizar os logs no Grafana da plataforma, configurar o plugin do Loki no Docker do servidor.
- O backup diário fica no próprio servidor. Levá-lo para fora é responsabilidade da equipe, como detalhado no capítulo de backup.
Qual usar em cada estágio
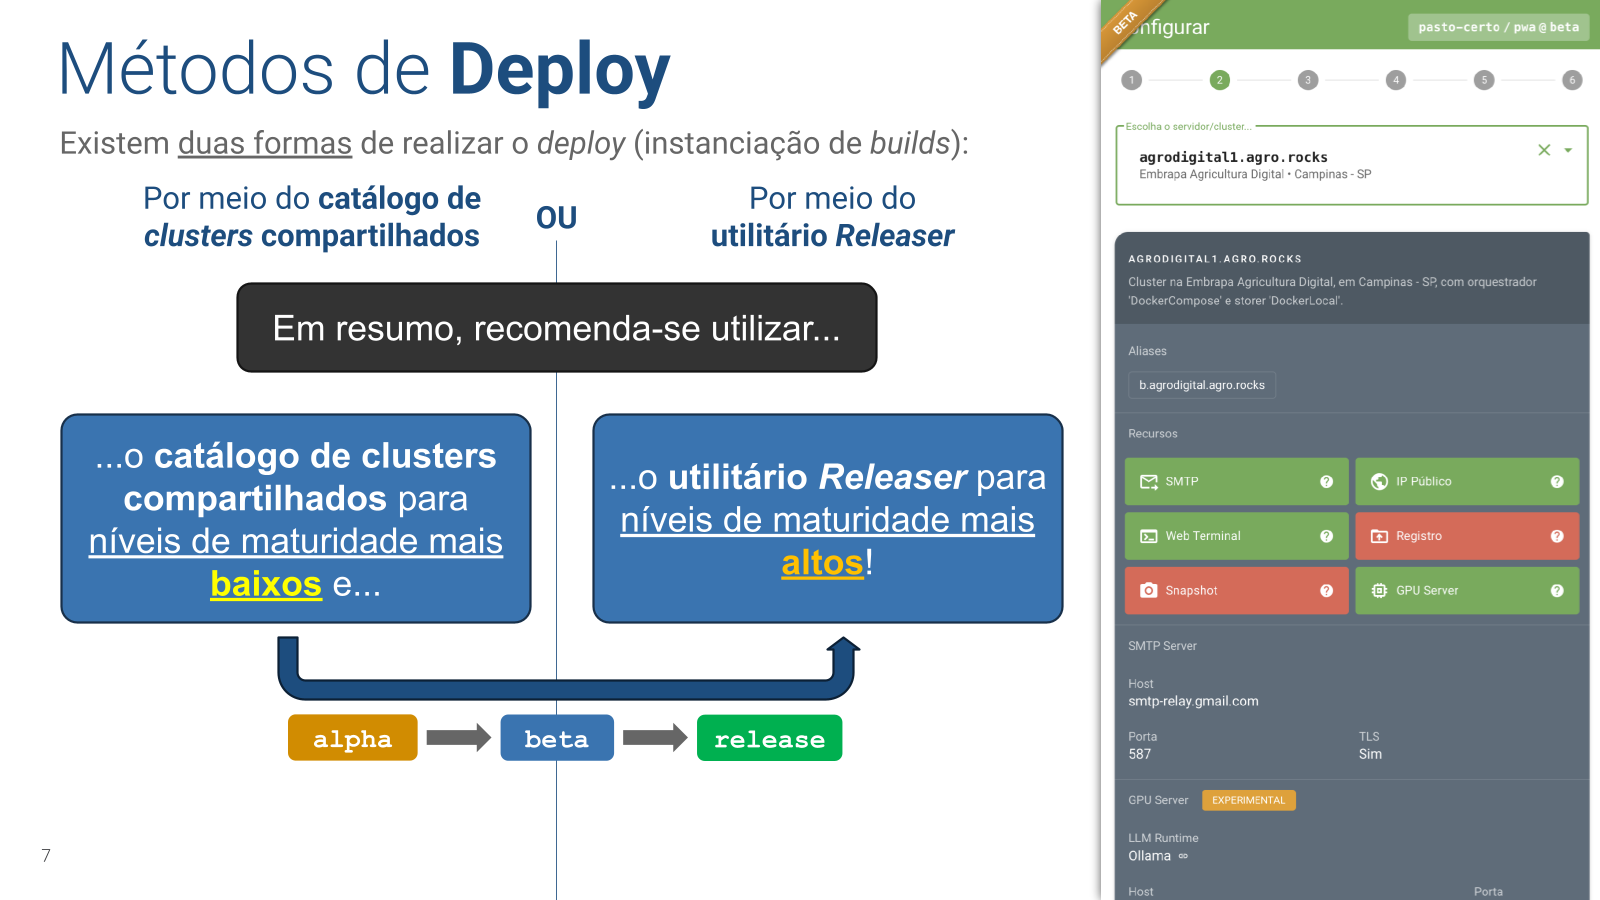
Em resumo, recomenda-se utilizar o catálogo de clusters compartilhados para os níveis de maturidade mais baixos (alpha e beta) e o utilitário Releaser para os níveis mais altos (release). Os contras do catálogo (recursos compartilhados e router único) são aceitáveis em testes, mas viram risco em produção. Os contras do Releaser (configuração por conta da equipe) são um investimento que só se justifica quando a aplicação está madura o suficiente para ir a produção.
Há uma segunda razão para separar a produção, que não é técnica: otimizar a equipe humana. Quando a release roda em uma máquina operada pela Unidade, empregados da própria Unidade passam a se envolver e a se responsabilizar pelo suporte e pela sustentação da aplicação em produção, em vez de tudo recair sobre a equipe central da plataforma. É esse envolvimento que dá escala à plataforma e que mantém o conhecimento sobre a aplicação perto de quem a usa.
A alpha fica no catálogo
A alpha deve permanecer no catálogo de clusters. Seu papel é o teste interno rápido e descartável, e ela se beneficia de tudo o que a plataforma automatiza. Mas há um motivo mais forte: a busca ativa de CVEs acontece apenas nos clusters compartilhados, nas imagens construídas no deploy da build, porque só nesse momento a plataforma conhece todas as dependências da aplicação. O Releaser ainda não faz essa varredura (está planejado). Manter a alpha no catálogo é, portanto, a forma de garantir que toda versão da aplicação passe pela varredura de vulnerabilidades antes de chegar à beta e à release.
A beta como ensaio da produção
O estágio beta é o coringa dessa recomendação. Ele pode ser instanciado no catálogo de clusters compartilhados, como qualquer estágio de testes, mas também pode ser instanciado pelo Releaser, em uma VM no mesmo data center onde a produção vai rodar. A vantagem desta segunda abordagem é que a beta passa a ter características de instanciação muito mais próximas das da release: o mesmo orquestrador, a mesma forma de expor portas e subdomínios, o mesmo virtual proxy e os mesmos certificados, o mesmo SMTP, as mesmas rotinas de backup e sanitização e, principalmente, a mesma equipe operando a máquina.
Isso importa porque a beta é o último teste antes da produção. Se ela roda em um ambiente que a plataforma configura sozinha e a release roda em um ambiente que a equipe configura por conta própria, a homologação valida a aplicação, mas não valida a operação: os erros de configuração de DNS, de proxy, de volumes ou de variáveis de ambiente só vão aparecer no dia do deploy em produção. Instanciar a beta pelo Releaser antecipa esses erros para a fase em que ainda é barato corrigi-los e, de quebra, serve de treinamento para quem vai operar a produção.
A recomendação, portanto, é gradual: comece a beta no catálogo de clusters enquanto o foco ainda é o comportamento da aplicação e, assim que a produção estiver no horizonte, migre-a para o Releaser no data center de destino, de preferência em uma VM separada da de produção (ou, na falta de recursos, na mesma VM, já que o Releaser isola as builds em pilhas de containers independentes). Como a alpha continua no catálogo, a varredura de CVEs segue cobrindo cada versão antes de ela chegar à beta.
Atenção! Enquanto a plataforma estiver em Beta Release, a disponibilização de aplicações em produção por meio do catálogo de clusters compartilhados é fortemente desencorajada, conforme já explicado no capítulo do Releaser. Essa é a situação atual, não a arquitetura-alvo: à medida que a plataforma amadurecer e ganhar controle fino de recursos, poderão existir clusters dedicados de produção no próprio catálogo.
Tiers de infraestrutura
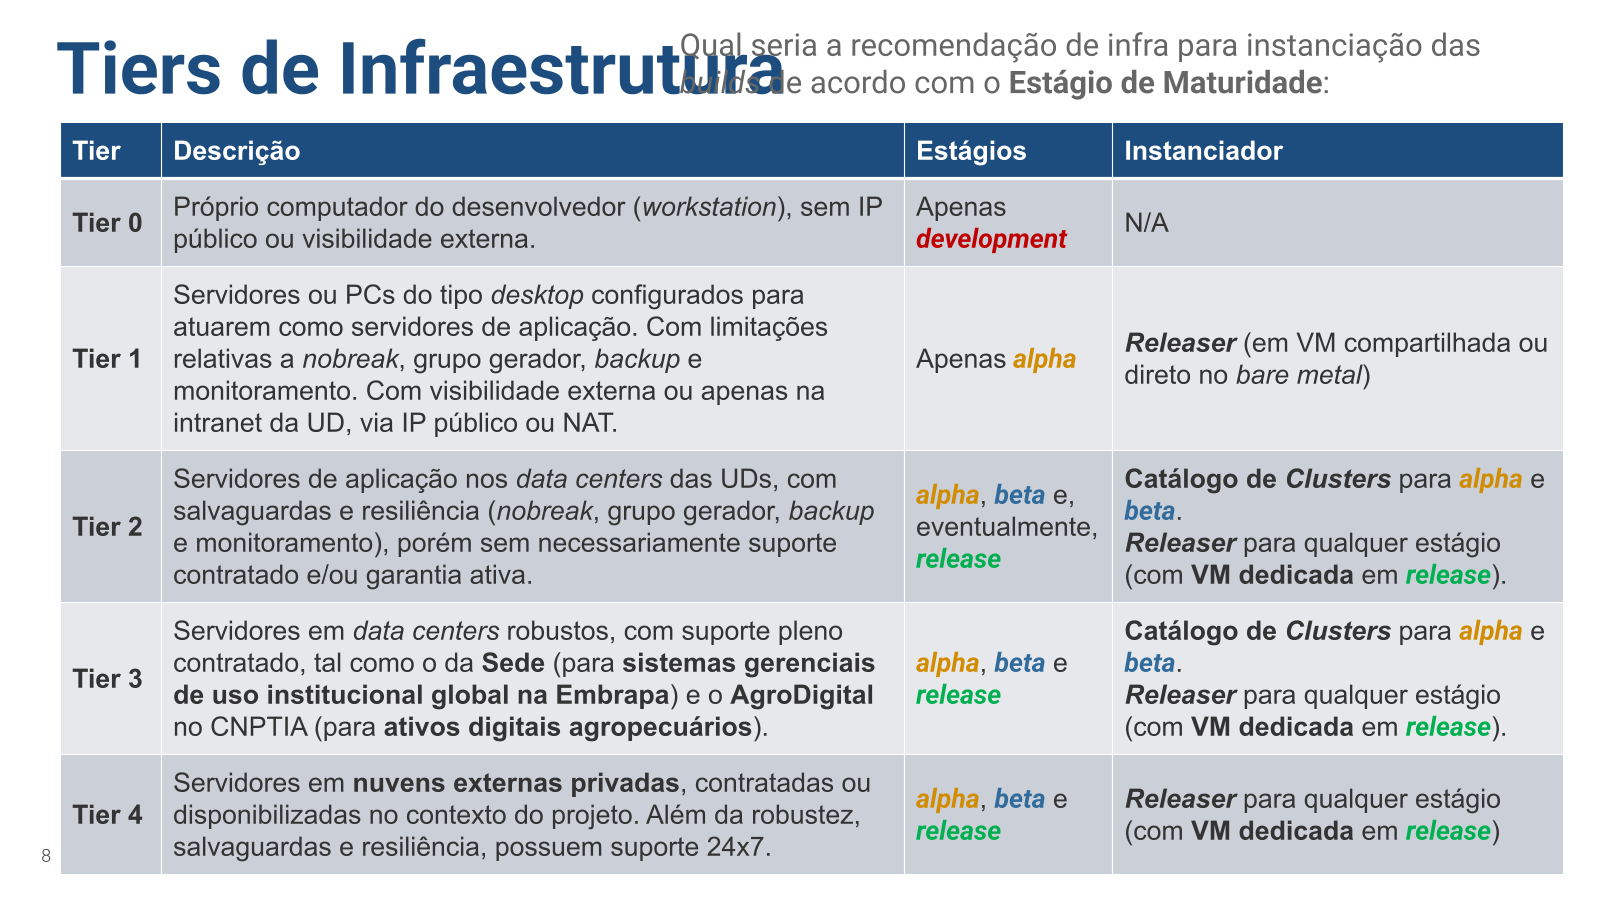
Para responder “onde instanciar”, é preciso classificar a infraestrutura disponível. A orientação adota cinco Tiers, definidos pela robustez do ambiente e pelo suporte que ele recebe:
| Tier | Descrição | Estágios | Instanciador |
|---|---|---|---|
| Tier 0 | Próprio computador do desenvolvedor (workstation), sem IP público ou visibilidade externa. | Apenas development | Não se aplica |
| Tier 1 | Servidores ou PCs do tipo desktop configurados para atuar como servidores de aplicação. Com limitações de nobreak, grupo gerador, backup e monitoramento. Com visibilidade externa ou apenas na intranet da Unidade, via IP público ou NAT. | Apenas alpha | Releaser (em VM compartilhada ou direto no bare metal) |
| Tier 2 | Servidores de aplicação nos data centers das Unidades, com salvaguardas e resiliência (nobreak, grupo gerador, backup e monitoramento), porém sem necessariamente suporte contratado ou garantia ativa. | alpha, beta e, eventualmente, release (veja os critérios adicionais) | Catálogo de clusters para alpha e beta. Releaser para qualquer estágio, com VM dedicada em release. |
| Tier 3 | Servidores em data centers robustos, com suporte pleno contratado, como o da Sede (para sistemas gerenciais de uso institucional global) e o AgroDigital, na Embrapa Agricultura Digital (para ativos digitais agropecuários). | alpha, beta e release | Catálogo de clusters para alpha e beta. Releaser para qualquer estágio, com VM dedicada em release. |
| Tier 4 | Servidores em nuvens externas privadas, contratadas ou disponibilizadas no contexto do projeto. Além da robustez, das salvaguardas e da resiliência, possuem suporte 24x7. | alpha, beta e release | Releaser para qualquer estágio, com VM dedicada em release. |
Dois pontos merecem destaque. O primeiro é que um cluster compartilhado do catálogo pode estar hospedado em Tier 2 ou Tier 3 (e muitos estão), mas o compartilhamento dos recursos é o que o torna inadequado para produção, não o Tier do data center. O segundo é que “VM dedicada” significa uma máquina virtual exclusiva para a build de produção, com recursos reservados e sem outras builds concorrendo por eles.
Critérios adicionais
O estágio de maturidade e o Tier dão a regra geral. Antes de decidir o destino de uma build de produção, a equipe deve cruzar essa regra com cinco critérios que podem endurecê-la ou flexibilizá-la:
- Sensibilidade dos dados. Aplicações que tratam dados pessoais (veja o capítulo sobre proteção de dados pessoais), dados sigilosos ou resultados de pesquisa ainda não publicados devem ficar em infraestrutura da Embrapa (Tier 2 ou Tier 3). A nuvem externa (Tier 4) só entra com contrato que cubra a guarda dos dados e a responsabilidade do operador.
- Requisito de disponibilidade. Pergunte quanto tempo a aplicação pode ficar fora do ar e quantos dados pode perder em um incidente (o mercado chama isso de RTO e RPO). Uma aplicação de campo, usada esporadicamente e que funciona offline, tolera horas de indisponibilidade, e isso pode justificar sua produção em Tier 2, no data center da própria Unidade. Um sistema gerencial que para o trabalho de muita gente quando cai pede Tier 3.
- Público e integrações. Aplicações de uso interno que dependem de serviços da rede corporativa (autenticação no AD/LDAP, SEI, bases da Sede) rodam melhor onde essas integrações já existem, em geral a Sede. Aplicações para o público externo precisam de IP público, proteção de borda e um domínio institucional, o que favorece o AgroDigital ou a Sede.
- Carga e recursos especiais. Aplicações com banco de dados pesado, processamento em lote, GPU para inferência ou muitos usuários simultâneos precisam de recursos reservados, e não devem dividir máquina com nada, nem mesmo com a própria beta.
- Capacidade de operação. O Releaser transfere para a equipe (ou para o NTI) a operação da máquina. Se ninguém na Unidade puder assumir atualização do sistema operacional, backup fora do servidor e resposta a incidentes, é melhor buscar a Sede ou o AgroDigital do que colocar produção em uma VM que não terá dono.
Recomendações às Unidades
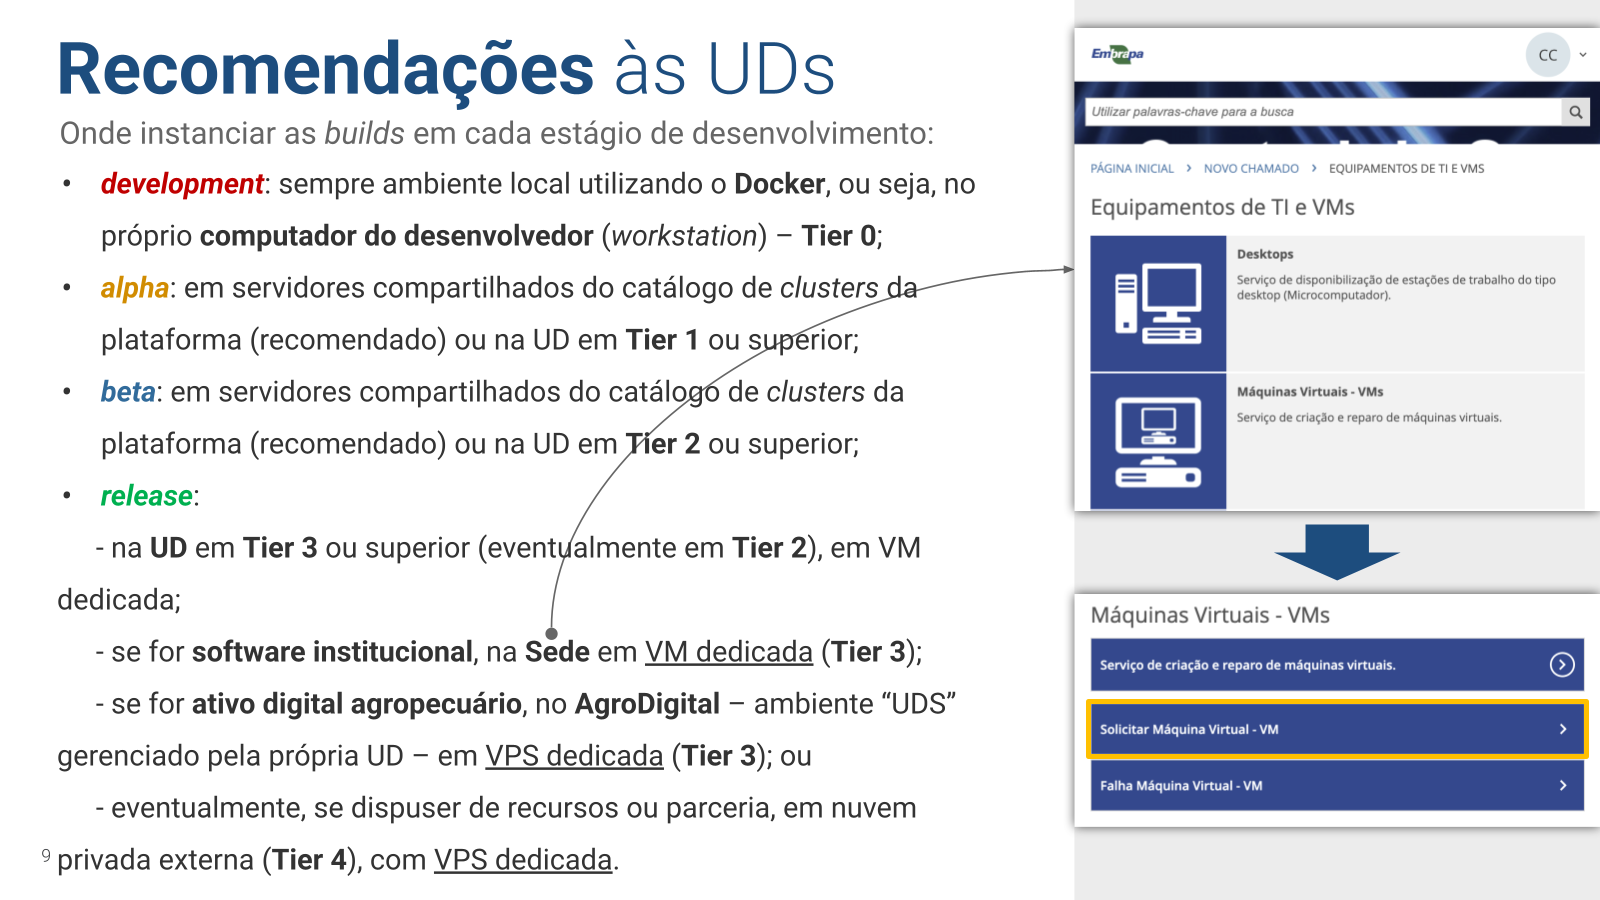
Onde instanciar as builds em cada estágio de desenvolvimento:
- development: sempre em ambiente local utilizando o Docker, ou seja, no próprio computador do desenvolvedor (Tier 0). Todos os boilerplates da plataforma já trazem a configuração para isso.
- alpha: em servidores compartilhados do catálogo de clusters da plataforma (recomendado, pela varredura de CVEs) ou na Unidade, em Tier 1 ou superior.
- beta: em servidores compartilhados do catálogo de clusters da plataforma (recomendado) ou na Unidade, em Tier 2 ou superior. Quando a produção estiver próxima, vale instanciá-la pelo Releaser no data center de destino, como ensaio da produção.
- release:
- na Unidade, em Tier 3 ou superior, em VM dedicada; eventualmente em Tier 2, quando os critérios adicionais permitirem (por exemplo, aplicação de campo com baixo requisito de disponibilidade e sem dados sensíveis);
- se for software institucional, na Sede, em VM dedicada (Tier 3);
- se for ativo digital agropecuário, no AgroDigital, no ambiente “UDS” gerenciado pela própria Unidade, em VPS dedicada (Tier 3); ou
- eventualmente, se o projeto dispuser de recursos ou de parceria, em nuvem privada externa (Tier 4), com VPS dedicada.
A VM dedicada no data center da Sede é solicitada pela Central de Atendimento da GTI, no serviço “Equipamentos de TI e VMs”, opção “Solicitar Máquina Virtual - VM”. No chamado, informe o projeto, a finalidade (produção de uma aplicação do Embrapa I/O), os recursos estimados (vCPUs, memória e disco) e que a máquina será operada pelo Releaser, o que dispensa a abertura de portas de entrada além das do serviço publicado.
Sobre a nuvem externa
A opção de nuvem privada externa (Tier 4) aparece como “eventual” por uma razão discutida com a GTI em setembro de 2025. A Lei nº 14.129/2021 (Lei do Governo Digital) e a estratégia que a materializa orientam a administração federal a contratar computação em nuvem como serviço, e a Portaria SGD/MGI nº 5.950/2023 estabelece o modelo obrigatório de contratação de software e de serviços de nuvem para os órgãos do SISP. Fornecedores de sistemas corporativos, por sua vez, passaram a oferecer suas soluções apenas nesse formato. Por outro lado, a experiência da GTI é que migrar para a nuvem as aplicações da forma como estão arquitetadas hoje tende a custar mais do que mantê-las nos data centers próprios, cujo investimento ainda está em amortização, além de trazer riscos próprios de segurança, de dependência do fornecedor e de gestão financeira. Assim, a nuvem externa fica reservada aos projetos que já dispõem desse recurso, em geral por meio de parceria, e não é um caminho que a Unidade deva contratar apenas para hospedar uma build de produção.
Subdomínios de projetos
Atenção! Assim como ocorre com aplicativos móveis nas lojas de terceiros (Google Play e App Store), aplicações web só podem ser colocadas em produção após devidamente qualificadas em TRL 7 (Beta Release) ou superior. Veja as orientações sobre o nível de maturidade e o capítulo sobre lançamento de MVPs.
Nos clusters do catálogo, as URLs são geradas automaticamente a partir dos domínios do cluster. Em produção, a aplicação precisa de um domínio institucional. Para os serviços publicados no data center da GTI, é criado no DNS da Embrapa um registro no formato nome-do-projeto.embrapa.br que redireciona qualquer prefixo (subdomínio), permitindo que a equipe utilize, no âmbito do projeto, endereços como www.nome-do-projeto.embrapa.br, app.nome-do-projeto.embrapa.br ou portal.nome-do-projeto.embrapa.br.
O registro do domínio do projeto é solicitado à GTI pela Central de Atendimento. A partir daí, a gestão dos subdomínios e dos certificados SSL de cada serviço é responsabilidade da equipe, no virtual proxy da própria VM, conforme as orientações do capítulo do Releaser. Em casos específicos, quando o serviço é publicado por trás do proxy central da GTI, os subdomínios passam a ser geridos pelos arquitetos de solução do projeto na ferramenta https://proxy.embrapa.io, uma instância do Nginx Proxy Manager. Consulte a SDAD para saber se o seu projeto se enquadra nesse caso.
Um exemplo concreto é o projeto Flora, publicado em outubro de 2025 em uma VPS dedicada no data center da Sede. A máquina expõe publicamente uma única porta, a do proxy; todos os serviços ficam em portas internas mapeadas pelo Nginx Proxy Manager, cada um com seu subdomínio. O Releaser mantém as builds atualizadas, o Portainer dá visibilidade de logs e terminal à equipe, e as integrações com o Sentry, o Matomo e o SonarQube continuam funcionando exatamente como nos clusters do catálogo, porque são configuradas por build e não pelo servidor.
Versões das imagens em produção
Uma dúvida que aparece na primeira produção é o que fazer com as tags das imagens Docker no docker-compose.yaml da aplicação. A regra tem dois lados que parecem contraditórios e não são: o boilerplate usa latest, a produção usa versão fixada, e a versão fixada precisa continuar sendo atualizada.
Por que o boilerplate fica em latest
Quem cria um projeto novo deve começar a desenvolver pela versão mais recente das tecnologias da stack. Se os boilerplates fixassem versões, a plataforma teria de reeditar todos eles a cada semana, porque sempre sai coisa nova, e as aplicações novas nasceriam defasadas. Por isso o catálogo não fixa versão, e a decisão fica com a equipe, no âmbito de cada aplicação, conforme explicado no capítulo de aplicações.
Por que a produção fixa a versão
Em latest, qualquer atualização das imagens traz o que quer que o fornecedor tenha publicado, inclusive uma versão maior com mudança de comportamento ou de formato de dados. Em release isso é inaceitável, e em beta é indesejável. A equipe tem três opções, da mais aberta à mais fechada:
latest: a aplicação acompanha tudo. Aceitável em alpha e em ferramentas que a equipe prefere manter sempre atuais (o n8n, por exemplo, para de receber melhorias se for congelado), mas não em bancos de dados nem em produção.- Versão maior (
postgres:18,n8nio/n8n:2): a aplicação continua recebendo os patches de segurança, desempenho e estabilidade daquela linha sem mudar de comportamento por conta própria. É a recomendação geral para beta e release, e é indispensável para bancos de dados, porque uma troca de versão maior pode tornar o volume de dados ilegível pela nova imagem. - Versão exata (
n8nio/n8n:2.39.5): a aplicação não muda até alguém decidir. É a opção quando um patch específico precisa ser evitado ou quando a homologação foi feita contra uma versão e a produção precisa ser idêntica.
Fixar a versão maior não protege de um bug introduzido em um patch: ele chega tanto por latest quanto por n8nio/n8n:2. Foi o caso do n8n 2.38.7 em setembro de 2026, que quebrou a integração com o Qdrant e foi corrigido no 2.39.5. Nessas situações o caminho é avançar para o patch corrigido (ou fixar temporariamente a versão exata anterior), e não abandonar a fixação por versão maior.
Por que a versão fixada precisa ser atualizada
Fixar não é congelar. Uma imagem de produção parada por meses acumula vulnerabilidades conhecidas, e é justamente isso que a varredura de CVEs do catálogo denuncia nas builds de alpha. Enquanto o Releaser não incorpora a varredura, a equipe precisa de uma rotina:
- Atualizar as imagens da build de produção em cadência definida (mensal, junto da sanitização, é um bom padrão), pelo procedimento de atualização das imagens do Releaser; nos clusters do catálogo, pelo restart da build com a opção “ATUALIZAR as imagens dos containers” na dashboard.
- Acompanhar a alpha da mesma aplicação no catálogo: se a varredura de CVEs acusar uma imagem-base, a produção com a mesma versão fixada está exposta e deve ser atualizada fora da cadência.
- Ler as notas de versão antes de avançar uma versão maior e, para bancos de dados, planejar a migração dos dados (na maioria dos casos, não há como voltar).
- Antes de qualquer atualização em release, ensaiar na beta e garantir um backup fora do servidor.
Retornar a uma versão anterior exige fixar explicitamente a tag antiga no docker-compose.yaml e publicar uma nova tag da aplicação; para bancos de dados, em geral, não é possível.
Responsabilidades por método
Escolher o Releaser é escolher um dono para a produção. A tabela abaixo deixa explícito o que muda de mãos em cada método. Nela, “plataforma” é a equipe do Embrapa I/O, e “equipe” é a equipe do projeto ou o NTI da Unidade que opera a máquina.
| Atividade | Catálogo de clusters | Releaser em máquina dedicada |
|---|---|---|
| Deploy, rollback e atualização de versão | Plataforma (automática, por tag) | Releaser (automático, por tag); a equipe acompanha |
| Construção das imagens e varredura de CVEs | Plataforma | Ainda sem varredura (Trivy no Releaser está planejado); a equipe mantém as imagens atualizadas |
| Monitoramento de disponibilidade e health check | Plataforma (dashboard e alertas) | Equipe (Portainer, Grafana da Unidade ou plugin do Loki) |
| Error tracking e analytics (Sentry, Matomo) | Plataforma | Plataforma (configurados por build) |
| Backup | Sob demanda pela dashboard; rotina do cluster pelo mantenedor | Diário pelo Releaser no servidor; cópia para fora do servidor pela equipe (regra 3-2-1) |
| Sanitização e limpeza de cache | Plataforma | Releaser (mensal) |
| Sistema operacional, Docker e segurança da máquina | Mantenedor do cluster | Equipe |
| DNS, virtual proxy e certificados SSL | Plataforma (automático) | Equipe |
| SMTP, GPU Servers e outras integrações de infraestrutura | Plataforma | Equipe |
| Resposta a incidentes (aplicação fora do ar, invasão, perda de dados) | Plataforma aciona a equipe | Equipe, com apoio da SDAD |
| Suporte ao usuário final | Equipe | Equipe |
Atenção! Antes de solicitar a VM de produção, a equipe deve nomear quem responde por cada linha da coluna “Releaser” e registrar isso no README do projeto. Uma VM sem dono é o cenário que mais gera incidentes na plataforma.
Resumo
| Estágio | Onde | Como |
|---|---|---|
| development | Computador do desenvolvedor (Tier 0) | Docker local, a partir do boilerplate |
| alpha | Catálogo de clusters (recomendado, pela varredura de CVEs) ou Unidade em Tier 1+ | Tag no GitLab; Releaser se for na Unidade |
| beta | Catálogo de clusters (recomendado) ou Unidade em Tier 2+; perto da produção, o data center de destino | Tag no GitLab; Releaser se for na Unidade ou como ensaio da produção |
| release | VM ou VPS dedicada em Tier 3 (Sede, AgroDigital ou Unidade); eventualmente Tier 2 ou Tier 4, conforme os critérios adicionais | Releaser |
Em caso de dúvida sobre o enquadramento da infraestrutura da sua Unidade em um dos Tiers, ou sobre a solicitação de VM e de subdomínio, entre em contato com a SDAD pelo e-mail gti.sdad@embrapa.br.