A plataforma Embrapa I/O varre toda hora as imagens em execução nos clusters em busca de vulnerabilidades conhecidas (CVEs) com o Trivy, e o resultado aparece no diálogo de monitoramento da build. Só que a maioria das CVEs HIGH e CRITICAL que o Trivy encontra nunca foi explorada por ninguém, e um aviso a cada uma delas só ensina a equipe a ignorar avisos.
O alerta de vulnerabilidades em exploração ativa faz o oposto: cruza o que o Trivy encontrou com catálogos públicos de falhas que já estão sendo exploradas e só se manifesta quando há algo que exige ação. Se chegou um alerta, ele merece atenção.
Atenção! O alerta vale para todos os estágios, inclusive
alphaebeta. Eles têm o mesmo tratamento derelease, porque também são porta de entrada para a infraestrutura e podem guardar dados sigilosos.
De onde vem a informação
A fonte é o CIRCL Vulnerability-Lookup, serviço aberto do CERT de Luxemburgo, que reúne vários catálogos de vulnerabilidades exploradas (KEV, de Known Exploited Vulnerabilities), cada um com o seu mantenedor:
| Catálogo | O que é |
|---|---|
| CISA | Catálogo oficial do governo dos EUA, com exploração confirmada |
| Shadowserver | Observações de honeypots |
| ENISA | Rede de CSIRTs da União Europeia |
| CIRCL | Catálogo do próprio CIRCL |
| Previdian | Catálogo de terceiros, mais amplo |
Os catálogos são baixados a cada 6 horas. Se o CIRCL estiver fora do ar, a plataforma recorre ao catálogo da CISA.
Não existe lista mantida pela Embrapa. Uma lista curada à mão cobriria o dia zero com textos prontos, mas dependeria de alguém lembrar de incluir cada falha, e ferramenta de segurança que depende de uma pessoa deixa de funcionar quando essa pessoa não está. Por isso a decisão é confiar em catálogos públicos e medir quanto confiar em cada um (veja a próxima seção).
Índice de confiabilidade e níveis
Os catálogos não são igualmente confiáveis, e a CISA, por exemplo, costuma demorar a incluir falhas recentes. Por isso a plataforma calcula, para cada CVE, um índice de confiabilidade de 0 a 100%, de forma determinística (sem inteligência artificial). O índice leva em conta:
- A qualidade de cada catálogo, pela nota que o próprio CIRCL publica a partir de critérios como comprovar, situar, antecipar e manter a informação;
- O que o catálogo afirma, de uma simples varredura em massa até comprometimento confirmado, e quão segura ele diz estar disso;
- Quantas fontes independentes sustentam a mesma CVE. Catálogos que apenas copiam outro não contam duas vezes.
O índice vira um nível de urgência:
| Índice | Nível | Leitura | Prazo sugerido |
|---|---|---|---|
| menos de 25% | Em observação | Sem e-mail e fora da caixa de exploração ativa; a CVE segue na lista comum de vulnerabilidades da build | — |
| 25% a menos de 50% | Alta | Programe a correção. | Até 7 dias |
| 50% a menos de 75% | Crítica | Corrija hoje. | Até 24 horas |
| 75% ou mais | Emergencial | Corrija agora. Tirar o estágio do ar é uma opção legítima até a correção. | Imediato |
Exemplo: PHP2Shell
Em 22/10/2026, a falha PHP2Shell (CVE-2026-109618 e CVE-2026-109619, no PHP) já constava como explorada no catálogo Previdian, que registrava exploração bem-sucedida, mas ainda não estava no da CISA. Apoiada por uma única fonte, de nota baixa, o índice foi de cerca de 34%: nível Alta. O alerta saiu, pedindo para programar a correção.
Quando a CISA incluiu a mesma CVE, passou a haver duas fontes independentes e o índice subiu para cerca de 60%: nível Crítica. A equipe recebeu na hora um novo alerta, agora dizendo “Corrija hoje”.
O alerta mostra sempre o nível, o índice e a leitura das fontes, por exemplo: “Alta (34%): 1 fonte independente (Previdian) relata exploração bem-sucedida”.
Quando o alerta é enviado
Um alerta só é gerado quando todas as condições abaixo são verdadeiras ao mesmo tempo:
- O nível é Alta ou superior (índice de 25% ou mais);
- A falha pode ser explorada pela rede (
AV:Nno vetor CVSS) e sem nenhum privilégio (PR:N), isto é, por qualquer pessoa na internet, sem login; - A exploração não depende de ação de um usuário (
UI:N), como abrir uma página ou um arquivo. Por isso falhas de navegador embutido (Chromium do Puppeteer ou do Playwright, por exemplo) não entram; - A falha tem impacto alto no sigilo ou na integridade dos dados (
C:HouI:Hno CVSS 3.1;VC:HouVI:Hno 4.0). Falhas que apenas derrubam o serviço não entram.
Pacotes de kernel (linux, kernel) encontrados na imagem também ficam de fora: o contêiner usa o kernel do servidor, e não o que vem na imagem.
Falhas que exigem acesso local ou uma conta autenticada não entram, por mais graves que sejam. Elas continuam na lista comum de vulnerabilidades da build.
A mensagem é montada em português a partir de dados estruturados (vetor CVSS, tipo de falha, sinal do catálogo e versões do Trivy), sem tradução automática. A descrição original, em inglês, vai no fim de cada item, com o link para o registro da CVE.
Quem recebe
Todos os membros da equipe do projeto que têm conta no Embrapa I/O (arquitetos, desenvolvedores e demais membros), e não só os mantenedores, porque quem reconhece a urgência muitas vezes é o técnico de TI que é apenas membro da equipe. A conta é criada no primeiro acesso ao dashboard, com o aceite dos termos: quem está na equipe mas nunca acessou não recebe. Cada pessoa recebe um único e-mail por ciclo, agrupado por CVE e ordenado pelo nível mais alto. Dentro de cada CVE, cada build aparece no formato projeto/app@estágio • serviços, com o servidor onde roda, a data da última varredura e a ação indicada. O rodapé traz o link para esta página.
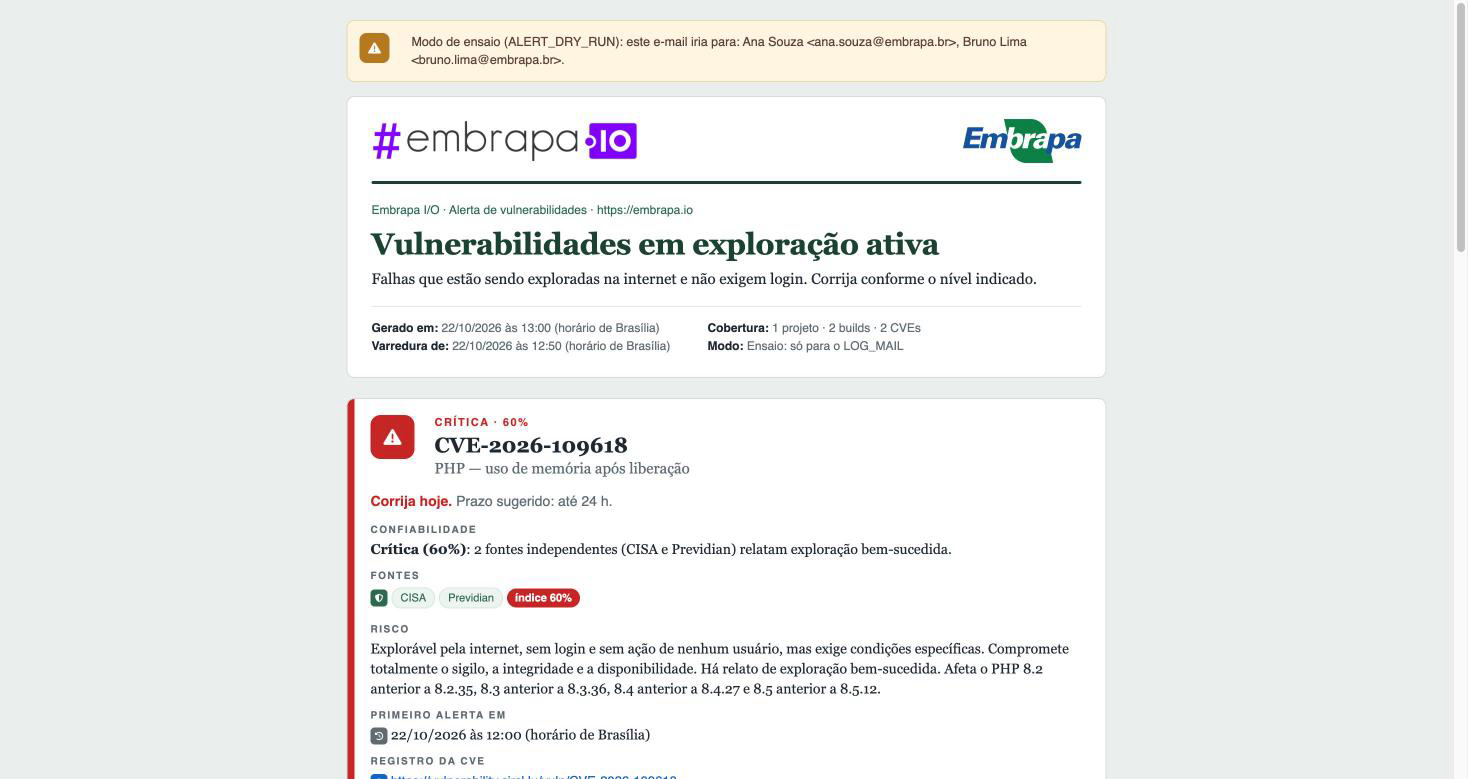
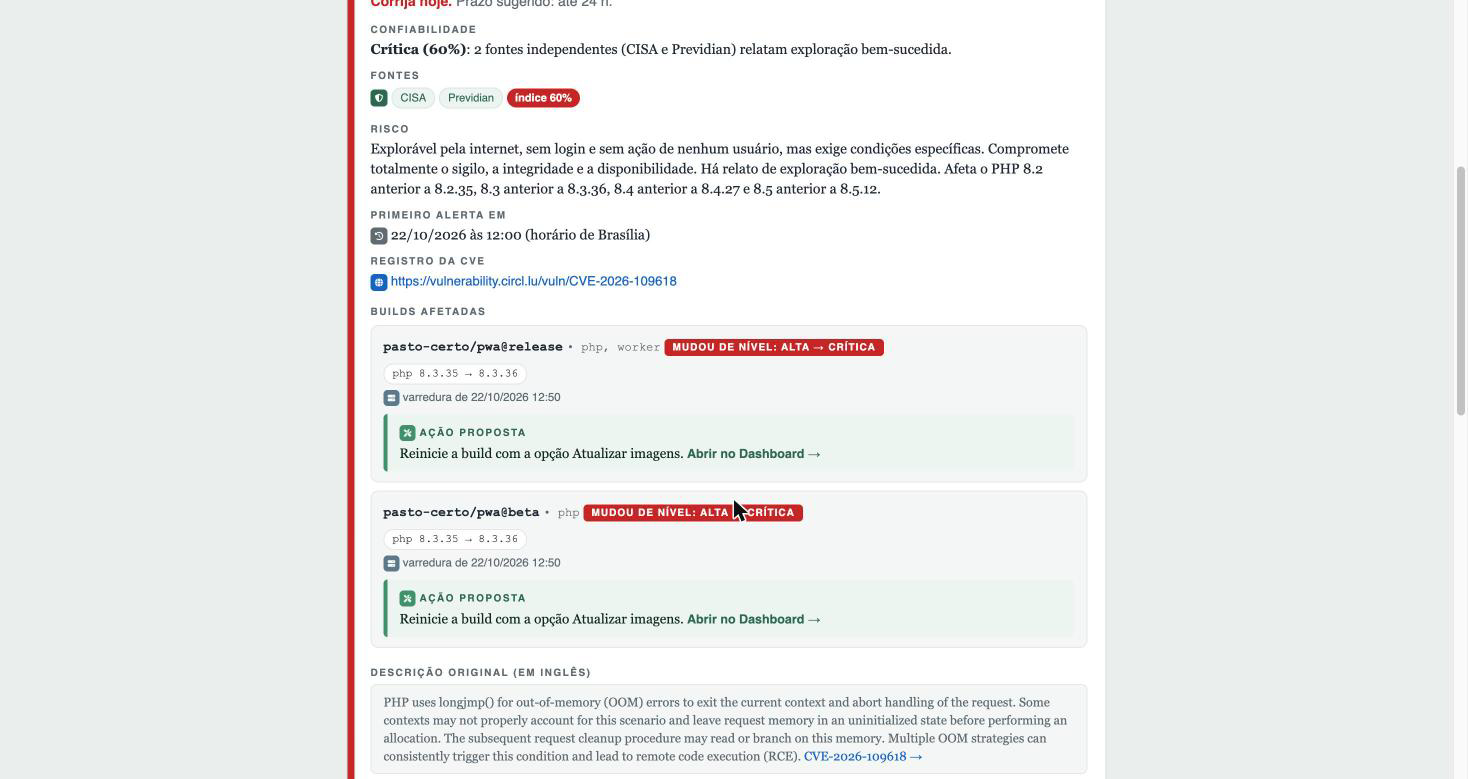
As imagens desta página usam dados fictícios, de um ambiente de teste.
Como qualquer pessoa da equipe pode corrigir a falha, não há descadastro: para deixar de receber, é preciso sair da equipe do projeto.
Uma cópia resumida, agrupada por projeto, vai também para o space de alertas críticos dos administradores da plataforma, que acompanham o que as equipes recebem.
Repetição, mudança de nível e encerramento
| Situação | |
|---|---|
| A build passa a ser afetada, ou a CVE entra em um catálogo, com nível Alta ou superior | Alerta imediato |
| O nível sobe (por exemplo, de Alta para Crítica porque outro catálogo incluiu a CVE) | Alerta imediato, na hora |
| O nível se mantém e a build continua afetada | Lembrete: Emergencial a cada 12 horas, Crítica a cada 24 horas e Alta a cada 7 dias |
| O nível desce (por exemplo, um catálogo retirou a entrada) | Nenhum; só muda o ritmo dos lembretes |
| A CVE some em todas as builds afetadas do projeto | Encerrado, um e-mail por CVE e projeto |
Sobre o “Encerrado”:
- Só é enviado se a situação chegou a Crítica ou Emergencial. Em casos de nível Alta, não há e-mail próprio: o encerramento aparece como uma linha no e-mail de alerta do projeto que sair no mesmo ciclo, se houver, e na linha “Corrigidas desde o último relatório” da Sentinela, quando o projeto a tem;
- Só vale quando a varredura da build é recente e a CVE não aparece mais. Uma build que não foi varrida (parada, sem contato ou com varredura que falhou) nunca é tratada como resolvida;
- O e-mail informa o motivo do encerramento (veja a próxima seção);
- Tudo o que vence na mesma hora (novos alertas, mudanças de nível, lembretes e encerramentos) vai junto no mesmo e-mail.
Quando o alerta sai sozinho
O alerta só vale para build no ar. Se a build deixa de estar no ar, os itens dela saem da caixa de exploração ativa e o episódio é encerrado, sem que a falha tenha sido corrigida. Uma build é considerada no ar quando:
- Build da plataforma: o status do deploy não é
INACTIVATED,UNDEPLOYINGnemREMOVING; - Plataforma e Releaser: a saúde mais recente tem ao menos um serviço em execução (
running); - Releaser: o último contato do servidor foi há no máximo 7 dias.
Cada encerramento registra o motivo, que aparece no e-mail “Encerrado”:
| Motivo | Significado | |
|---|---|---|
Corrigida (fixed) |
A CVE não aparece mais na varredura recente da build | Encerrado, se chegou a Crítica ou Emergencial |
Desativada (deactivated) |
A build foi desativada ou parada, e nenhum serviço está em execução | Encerrado, se chegou a Crítica ou Emergencial, dizendo que a build saiu do ar |
Sem contato (unreachable) |
O servidor do Releaser está há mais de 7 dias sem contato | Nenhum; só uma linha no space de alertas dos administradores |
Atenção! Sair do ar não é o mesmo que estar corrigida. Se a build voltar a rodar com a falha, o alerta recomeça como um episódio novo.
O que fazer
Cada item do alerta traz a ação indicada para aquela build, escolhida por regras fixas, na ordem a seguir. O que importa é onde a build roda.
Build em cluster compartilhado
| Situação | Ação |
|---|---|
| Não há versão corrigida e a build não é atualizada há mais de 6 meses | Tire do ar, com backup antes. Uma build esquecida no ar é exatamente a porta de entrada que se quer fechar. Se há versão corrigida, vale atualizar, mesmo em build antiga: aplicações de prateleira (n8n, WordPress) costumam receber só o restart com atualização das imagens, e nunca um deploy |
| Não há versão corrigida e o nível é Alta | Restrinja o acesso ou tire do ar os estágios que não são de produção (alpha e beta) |
| Não há versão corrigida e o nível é Crítica ou Emergencial | Recomenda-se tirar o estágio do ar até haver correção: faça um Backup e depois Desativar. Manter no ar é uma decisão consciente da equipe |
Há versão corrigida e a falha está em uma dependência da aplicação (npm, composer, pip, gem, binário Go, jar…) |
Atualize a dependência no código (do pacote e versão instalada para a corrigida, no arquivo de lock indicado no item) e gere uma nova tag. Reiniciar não corrige, porque a dependência vem do código da aplicação, e não da imagem |
Há versão corrigida, mas a versão está fixada no Dockerfile ou no docker-compose.yml (versão exata ou digest) |
Suba a versão fixada para a corrigida no repositório e gere uma nova tag |
Há versão corrigida e a imagem é latest ou está sem tag (ou o serviço é build: sobre uma base latest) |
Fixe antes de atualizar. Reiniciar com atualização pode saltar de versão maior e, em banco de dados, até tornar o volume ilegível. No docker-compose.yml ou no Dockerfile, fixe a versão maior em uso (por exemplo, postgres:16, e não postgres:latest), gere uma nova tag e só então atualize as imagens |
Há versão corrigida e a imagem é floating parcial (8.3-apache, sem a versão exata), ou o serviço é build: sobre uma base assim |
No dashboard, abra a build, clique em Reiniciar e marque Atualizar imagens |
Se um alerta Emergencial continuar sem correção, ele volta a cada 12 horas dizendo: “Ainda vulnerável. Se não for possível corrigir agora, tire o estágio do ar.”
Build implantada pelo Releaser
O dashboard não alcança os servidores que usam o Releaser, por desenho. As regras da tabela acima para build antiga, sem versão corrigida, dependência da aplicação, versão fixada e latest ou sem tag valem também aqui, inclusive a de atualizar a dependência no código e gerar uma nova tag, porque o restart não a corrige. Na última, em vez do Reiniciar do dashboard, o alerta traz o comando equivalente, a executar no servidor indicado:
io restart <projeto>/<app>@<estágio> --upgrade
A opção --upgrade renova as imagens, reconstrói os serviços build: e reinicia a stack. Quando a ação é tirar do ar, o alerta traz também o comando:
io stop <projeto>/<app>@<estágio>
O comando io restart --upgrade existe a partir do Releaser 1.26.10-10. Se o Releaser daquele servidor for de uma versão anterior, o alerta traz o caminho manual (docker pull e io deploy --force) e a sugestão de atualizar o Releaser. Se o servidor está há mais de 24 horas sem contato, o alerta sai mesmo assim, avisando a data do último dado de vulnerabilidades. Passados 7 dias sem contato, o alerta é encerrado (veja Quando o alerta sai sozinho).
Pedir ajuda à Sentinela
Quando o projeto tem a Sentinela configurada e ativa, o e-mail traz o botão Pedir à Sentinela uma checagem no código, que abre no dashboard o diálogo da Sentinela do projeto, de onde se pede a execução. Nada é executado só por abrir o link.
A plataforma nunca derruba nada sozinha
Toda ação é proposta pela plataforma e executada pela equipe. Nenhuma build é parada, reiniciada ou atualizada automaticamente por causa de um alerta. Isso vale inclusive para o nível Emergencial: tirar do ar é uma recomendação, nunca uma ação automática.
Correção com apoio de agentes de IA (MCP)
O MCP do dashboard tem a ferramenta list_critical_cves e o prompt guiado fix_critical_cves, que reúnem em uma só consulta as builds com alerta ativo dos seus projetos: nível, índice, pacote, versão instalada e corrigida, tipo do pacote (sistema ou dependência da aplicação), arquivo de lock afetado, classificação da imagem, ação indicada, repositório e a versão implantada. Com isso, um agente de IA (Claude, Gemini, Copilot, Cursor…) pode ler o código na versão que está no ar e propor a correção build a build.
Um exemplo de pergunta:
Verifique os alertas de CVEs críticos em meus projetos e me oriente em cada um como agir.
Para cada alerta, o agente:
- Lista as builds afetadas, da mais urgente para a menos;
- Lê o repositório da build na versão implantada, para saber onde a dependência ou a imagem é declarada;
- Propõe a correção conforme a tabela de ações: atualizar a dependência e gerar tag, fixar a versão maior antes de atualizar, subir a versão fixada ou reiniciar com atualização das imagens;
- Aponta, quando for o caso, que a opção mais prudente é tirar o estágio do ar até haver correção.
Atenção! O agente nunca altera nada sem a sua confirmação: nem o código, nem a tag, nem a build. Ele propõe, mostra o que mudaria e espera o seu “pode fazer”. Como em todo alerta, a decisão e a execução são da equipe.
Onde mais as vulnerabilidades aparecem
O alerta, o dashboard e a Sentinela leem o mesmo conjunto de vulnerabilidades em exploração ativa, então os três sempre concordam:
-
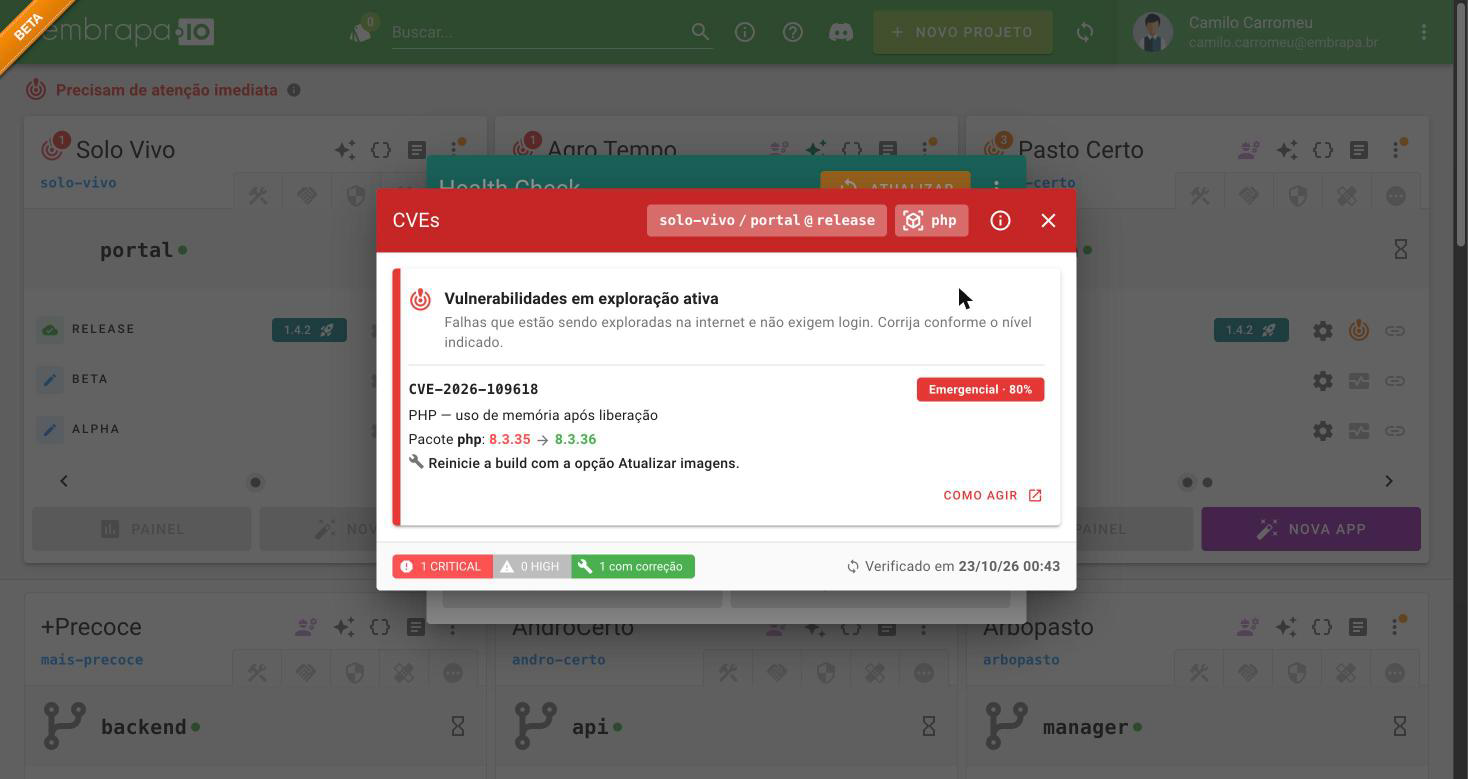
Dashboard: uma caixa Vulnerabilidades em exploração ativa no topo do diálogo de vulnerabilidades da build, com nível, índice, pacote, versão instalada e corrigida, a ação indicada e o link para esta página. Essas CVEs saem da lista comum logo abaixo, para não aparecerem duas vezes. O ícone
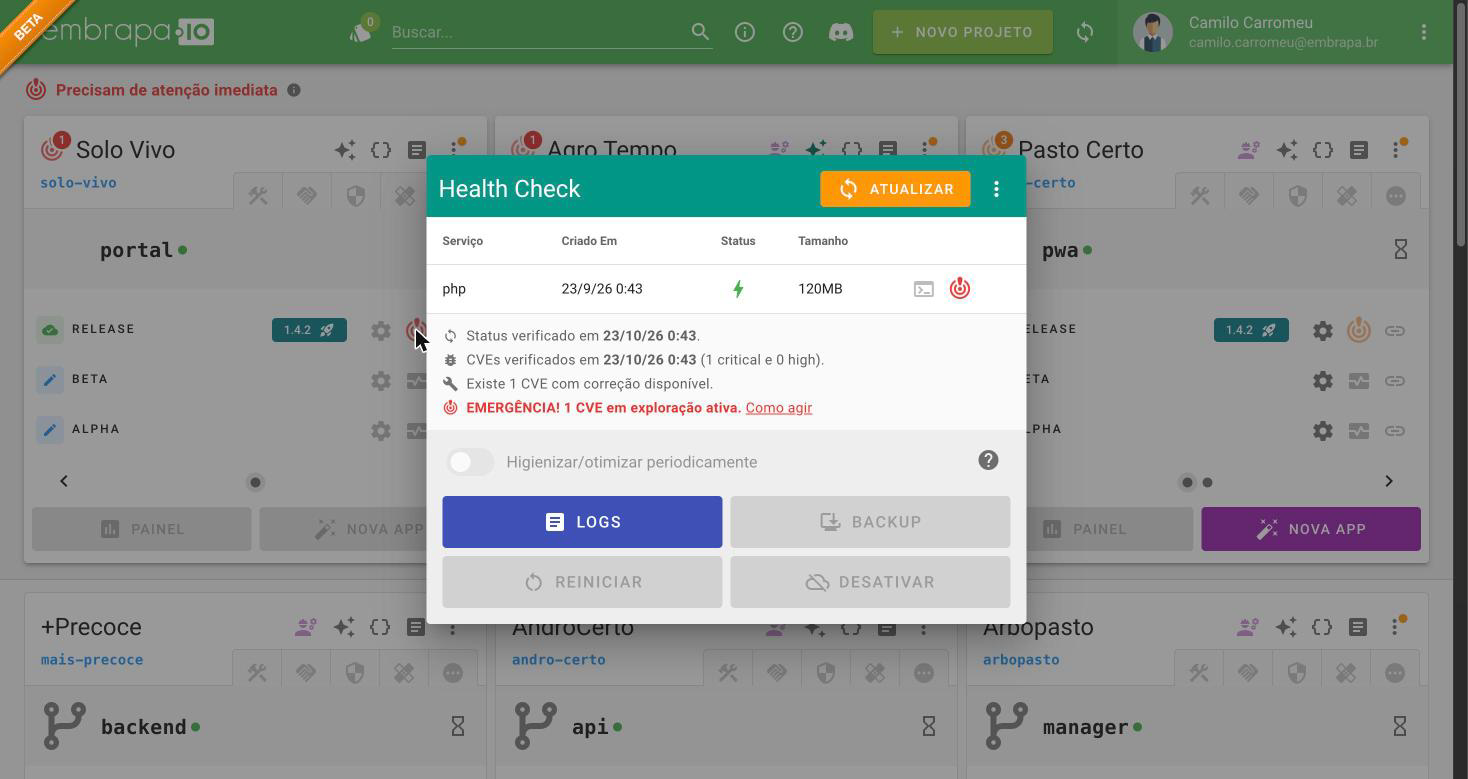
crisis_alertpulsa na linha do serviço, no card da aplicação e como badge no card do projeto, em laranja para o nível Alta e em vermelho para Crítica e Emergencial. Os projetos com alerta ativo ficam no topo da lista, numa faixa própria, Precisam de atenção imediata, qualquer que seja o filtro;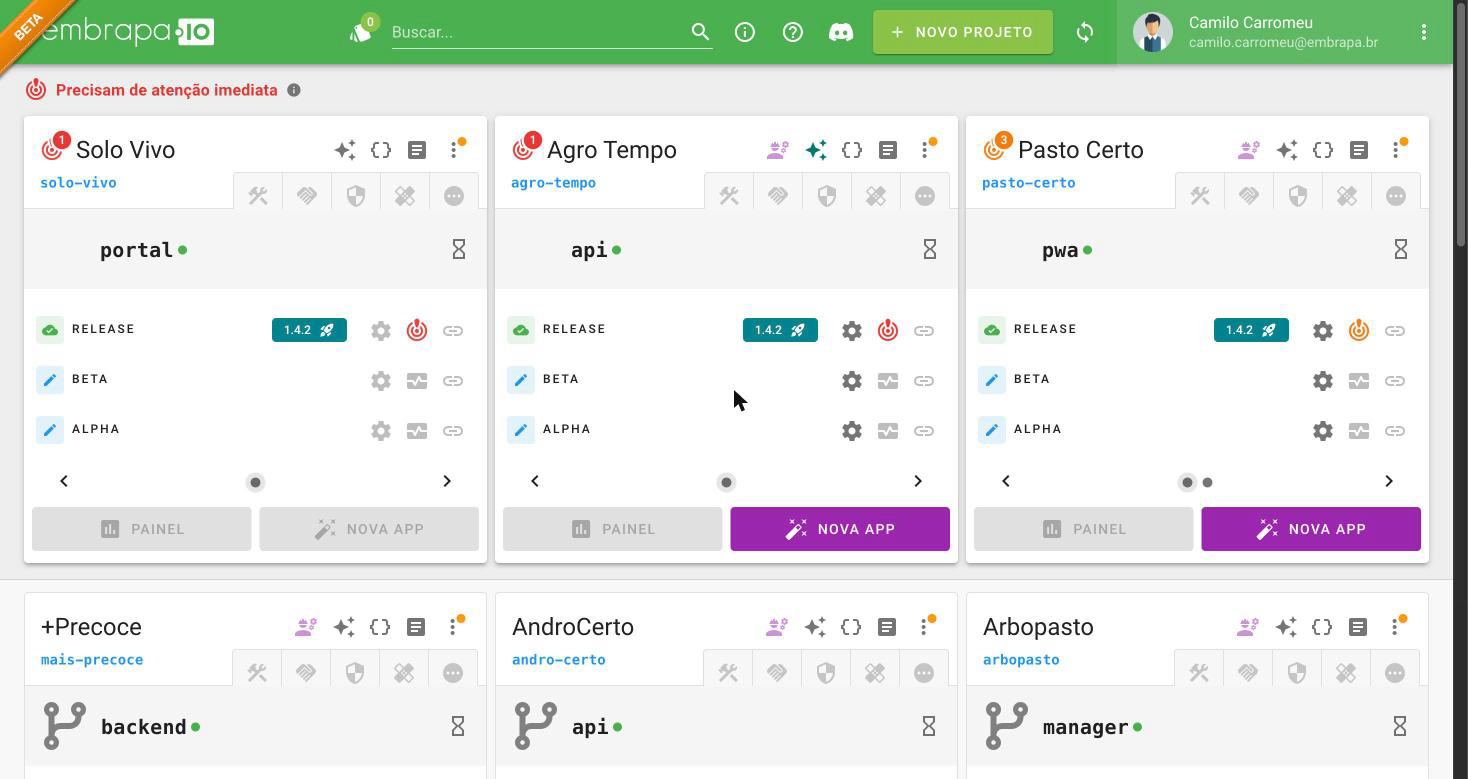
- Sentinela: os relatórios diário e semanal trazem, antes de qualquer outro achado, uma seção própria com o mesmo título, com nível, índice, há quanto tempo o primeiro alerta foi enviado, quantos lembretes já saíram e a ação indicada. A seção é montada a partir dos dados, não pelo modelo de IA, que não pode reescrevê-la nem rebaixar a severidade. Essas CVEs saem da seção comum de vulnerabilidades, e as corrigidas na semana aparecem numa linha à parte;
- MCP: as ferramentas
build_infoeget_build_healthdo MCP do dashboard trazem o campoexploited, elist_critical_cveslista todas as builds com alerta ativo (veja Correção com apoio de agentes de IA).
Perguntas frequentes
Recebi um alerta, mas minha aplicação não usa o trecho vulnerável. O Trivy sabe que o pacote está na imagem, mas não se o seu código usa o caminho da falha. Mesmo assim, atualizar custa pouco e o alerta é sobre exposição pela internet: corrija. Se tiver dúvida, peça uma checagem à Sentinela.
O Trivy acusou a versão errada. Acontece, por exemplo, quando um ENV PHP_VERSION no Dockerfile ficou desatualizado em relação ao que a imagem realmente instala. Corrija a variável.
A CVE deixou de aparecer sem que eu fizesse nada. Um catálogo pode ter retirado a entrada, o que reduz o nível. Se a CVE some do dashboard mas a build não foi varrida recentemente, ela não é considerada resolvida.
Quem recebe os alertas? Todos os membros da equipe do projeto que têm conta no Embrapa I/O (a conta é criada no primeiro acesso à plataforma). Como a falha pode ser corrigida por qualquer pessoa da equipe, não há opção de descadastro: para deixar de receber, é preciso sair da equipe do projeto.